Como APIs de dados da web podem ampliar o alcance de agentes de IA
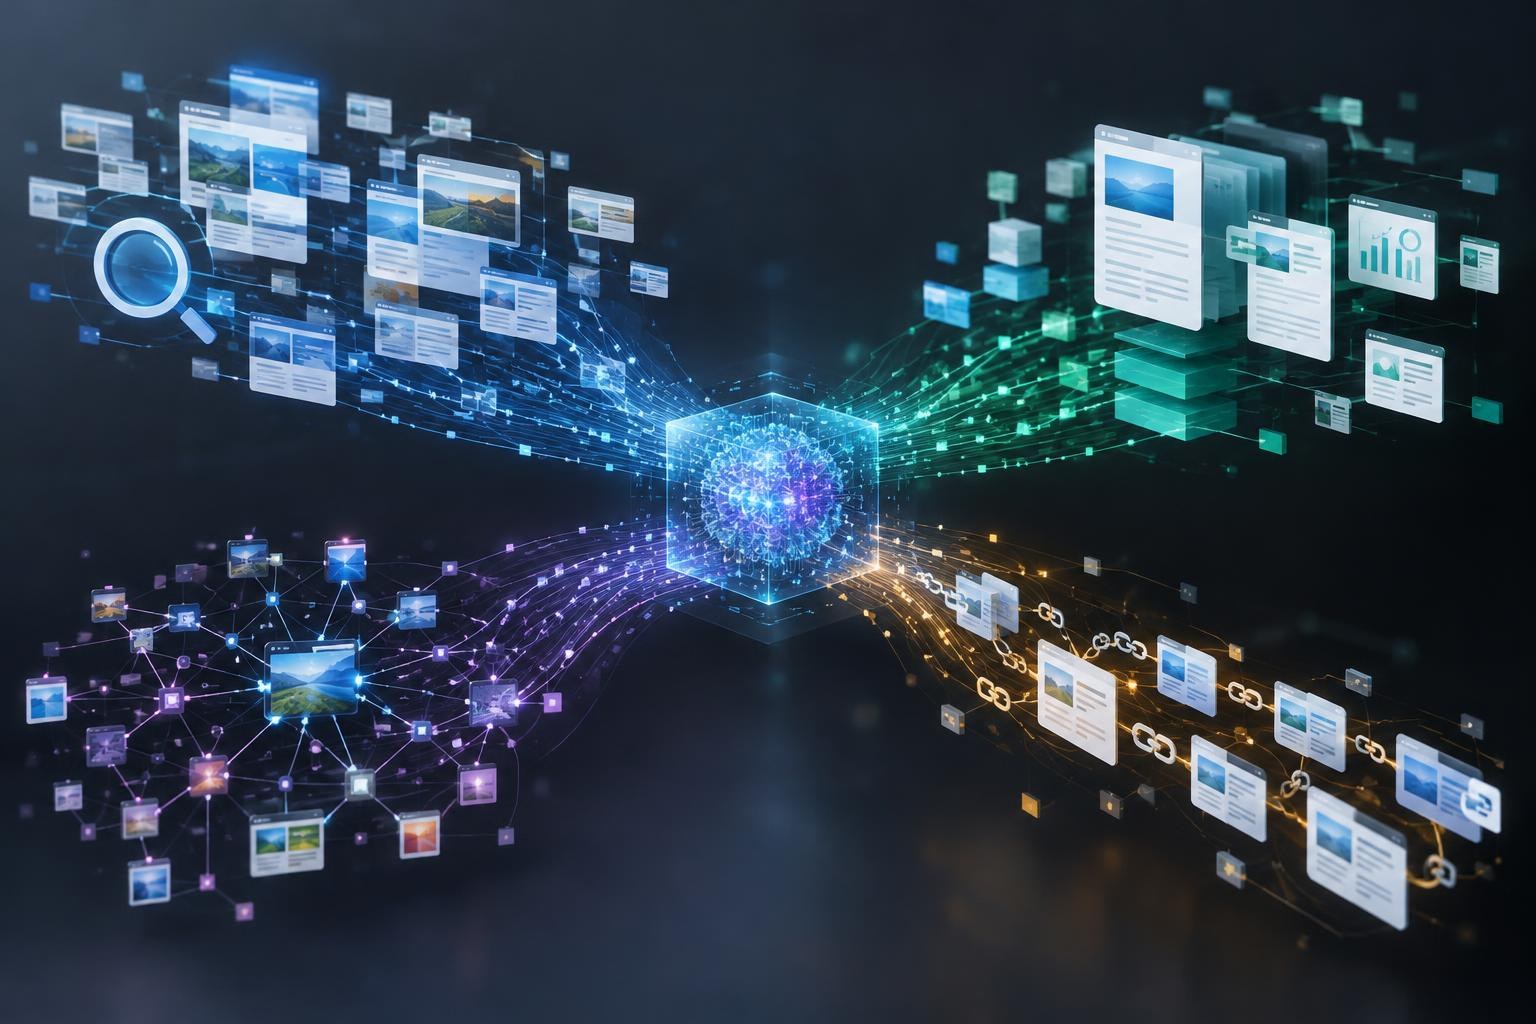
A proposta da Web Data API da Decodo reúne busca, scraping, mapeamento e rastreamento de páginas em uma única chave, mirando agentes de IA e pipelines de recuperação de informações.
Agentes de inteligência artificial podem responder a perguntas, executar etapas de um fluxo de trabalho e apoiar decisões, mas sua utilidade depende das informações às quais conseguem ter acesso. Quando a tarefa exige consultar páginas da web, encontrar conteúdo relevante e organizá-lo para uso posterior, a conexão entre o agente e os dados disponíveis on-line passa a ser parte importante da arquitetura.
Foi nesse contexto que a Decodo anunciou a Web Data API, uma interface que reúne scraping, busca, mapeamento e crawling sob uma única chave. A proposta é atender agentes de IA e pipelines de recuperação de informações. O anúncio apresenta uma forma de concentrar diferentes operações relacionadas à obtenção de dados da web em um ponto de integração, em vez de tratar cada atividade como um serviço totalmente separado.
A iniciativa chama atenção não apenas pelo nome de uma nova API, mas pelo tipo de problema que tenta endereçar: transformar conteúdo publicado em páginas da web em informação que sistemas automatizados possam localizar e utilizar. Entender o que cada operação significa, quais etapas podem estar envolvidas e quais cuidados precisam ser considerados ajuda equipes técnicas e de negócios a avaliar se uma solução desse tipo faz sentido para seus projetos.
O que significa reunir operações de dados da web
Uma API permite que sistemas diferentes se comuniquem por meio de solicitações e respostas estruturadas. No caso de uma interface voltada a dados da web, a aplicação pode enviar uma tarefa e receber informações processadas ou coletadas, conforme os recursos oferecidos pelo serviço. Em vez de depender de uma pessoa para abrir páginas, copiar trechos e organizar resultados manualmente, um software pode realizar parte desse trabalho de maneira automatizada.
O anúncio da Decodo descreve quatro operações: scraping, busca, mapeamento e crawling. Elas são relacionadas, mas não significam exatamente a mesma coisa. Cada uma pode ocupar uma etapa distinta de um fluxo de coleta e utilização de informações. Reunir essas operações sob uma única chave de acesso indica uma tentativa de simplificar a integração do ponto de vista operacional. Isso não elimina a necessidade de entender o funcionamento de cada etapa nem de definir critérios para o uso dos dados.
Busca: localizar páginas ou informações relevantes
A busca é a atividade de encontrar páginas ou conteúdos relacionados a uma consulta. Em um cenário com agentes de IA, uma solicitação pode exigir informações atuais ou específicas que não estejam disponíveis no contexto inicial do modelo. Um componente de busca pode ajudar a localizar materiais que mereçam ser analisados antes de uma resposta ou de uma ação posterior.
Encontrar páginas, porém, não é o mesmo que confirmar que elas são corretas, atualizadas ou adequadas à finalidade. Uma lista de resultados pode incluir conteúdos repetidos, desatualizados, superficiais ou pouco relacionados ao assunto. Por isso, projetos que usam busca automatizada precisam definir como avaliar relevância e qualidade, além de considerar quais páginas podem ser consultadas e em que condições.
Scraping: extrair dados de páginas
Scraping é o processo de extrair informações de páginas da web. Dependendo do objetivo e da ferramenta, a extração pode se concentrar em elementos como textos, títulos, links ou outros dados que estejam disponíveis na página. O resultado pode ser convertido em uma estrutura que um sistema consiga processar com mais facilidade do que um documento visual apresentado a uma pessoa.
Esse processo não deve ser entendido como uma autorização automática para copiar qualquer conteúdo. A viabilidade técnica de acessar uma página e a permissão para reutilizar suas informações são questões diferentes. Direitos autorais, termos de uso, privacidade, regras de acesso e requisitos legais podem variar de acordo com o site, o dado e a finalidade da coleta. Uma implementação responsável precisa levar esses fatores em conta antes de automatizar a extração.
Crawling: percorrer páginas e links
Crawling descreve a navegação automatizada por páginas e links. Um sistema pode começar por determinados endereços e seguir conexões para descobrir outros conteúdos, conforme limites e regras definidos. Essa atividade pode ser útil quando o objetivo não é apenas consultar uma página isolada, mas localizar um conjunto de documentos relacionados ou acompanhar uma estrutura de conteúdo.
O rastreamento precisa ser planejado para não se transformar em uma coleta indiscriminada. Limitar o escopo, controlar a frequência de solicitações e respeitar as regras dos sites são cuidados importantes. Também é necessário definir quando parar, como lidar com páginas duplicadas e quais tipos de conteúdo devem ser excluídos. Sem esses controles, o volume de dados pode crescer sem que a qualidade das informações acompanhe esse crescimento.
Mapeamento: compreender a estrutura de um site
Mapeamento, nesse contexto, está relacionado a identificar ou organizar páginas e caminhos dentro de um domínio ou de um conjunto de conteúdos. Pode ajudar a entender a estrutura disponível antes de uma coleta mais detalhada. Por exemplo, uma equipe pode precisar descobrir quais seções contêm documentação, páginas de suporte ou informações públicas de produto, sem tratar todas as páginas como igualmente relevantes.
O anúncio da Web Data API cita o mapeamento como uma das operações reunidas, mas não detalha, no material fornecido, exatamente quais recursos ou parâmetros essa função oferece. Assim, é mais adequado interpretar o termo em seu sentido geral e consultar a documentação do produto para confirmar como a operação funciona, quais dados retorna e quais limites se aplicam.
Por que agentes de IA precisam de acesso à web
Um modelo de IA pode gerar respostas a partir do que aprendeu durante seu treinamento e do contexto que recebe em uma conversa ou tarefa. Quando o problema depende de informações externas, específicas ou que podem ter mudado, um sistema pode precisar buscar dados adicionais. Conectar agentes a fontes da web é uma forma de ampliar o contexto disponível no momento da execução, mas essa conexão não garante por si só que a resposta final será correta.
Um agente pode receber uma instrução, pesquisar páginas, selecionar conteúdos, extrair trechos e usar essas informações para responder ou executar uma etapa. Em sistemas mais elaborados, essas ações podem fazer parte de um fluxo com validação, registro de resultados e intervenção humana. A API pode servir como uma camada de acesso às operações de dados, enquanto a aplicação responsável pelo agente define a lógica, os critérios e a experiência oferecida ao usuário.
Essa distinção é importante: uma API de dados não é necessariamente o agente, nem substitui o modelo de linguagem, a aplicação, a base de conhecimento ou as regras de segurança. Ela pode ser um componente de uma arquitetura maior. A qualidade do resultado depende da combinação entre acesso aos dados, seleção de fontes, processamento, instruções e avaliação das respostas.
O papel da recuperação de informações
Pipelines de recuperação de informações organizam etapas para localizar conteúdos relevantes diante de uma consulta. Em termos gerais, um pipeline pode receber uma pergunta, buscar documentos, selecionar os materiais mais pertinentes e disponibilizá-los a outro componente para análise. Quando a origem dos dados é a web, operações como busca e extração podem alimentar esse processo, desde que os dados sejam obtidos e tratados de maneira apropriada.
Uma recuperação bem planejada pode ajudar a reduzir respostas baseadas apenas em contexto incompleto. Em vez de pedir ao modelo que responda sem consultar materiais pertinentes, a aplicação pode fornecer documentos que apoiem a elaboração da resposta. Ainda assim, é necessário preservar a relação entre cada informação e sua origem, avaliar se as páginas são confiáveis e evitar apresentar inferências como fatos confirmados.
Também importa distinguir recuperação de geração. A recuperação encontra e organiza materiais; a geração produz uma resposta ou outro conteúdo com base no contexto disponível. Um sistema pode falhar em qualquer uma dessas etapas. Pode não localizar uma página relevante, escolher um documento inadequado, extrair conteúdo de forma incompleta ou interpretar incorretamente as informações. Projetar um fluxo robusto significa observar o conjunto, e não apenas a capacidade de acessar páginas.
O que pode mudar com uma única chave de acesso
Segundo o anúncio, a Web Data API reúne scraping, busca, mapeamento e crawling sob uma única chave. Em uma integração, concentrar diferentes operações em uma interface pode diminuir a quantidade de componentes que uma equipe precisa conectar e administrar. Em tese, isso pode facilitar a construção de protótipos e reduzir parte do trabalho necessário para alternar entre ferramentas distintas.
Uma integração unificada também pode tornar mais claro o ponto de entrada para uma aplicação. Desenvolvedores podem organizar as solicitações relacionadas à coleta de dados a partir de um serviço, em vez de criar conexões independentes para cada tarefa. Para equipes que mantêm agentes ou pipelines, essa organização pode facilitar a documentação interna e a compreensão de quais operações estão sendo acionadas.
Esses benefícios potenciais dependem, contudo, dos detalhes da implementação. Uma única chave não significa necessariamente que todas as operações tenham a mesma configuração, o mesmo custo, a mesma disponibilidade ou as mesmas condições de uso. Também não comprova, por si só, que a integração será simples para qualquer equipe. Antes de adotar a ferramenta, é preciso avaliar a documentação, os formatos de entrada e saída, os limites técnicos e a adequação ao caso de uso.
Usos possíveis em diferentes contextos
Uma API que oferece operações de acesso a dados da web pode ser considerada em vários tipos de projeto. As possibilidades abaixo são exemplos gerais de aplicação e não uma confirmação de funcionalidades específicas ou resultados garantidos pela solução anunciada. Cada uso depende da capacidade real da API, das fontes consultadas, das regras aplicáveis e dos controles implementados por quem constrói o sistema.
Assistentes que respondem sobre documentação
Uma equipe pode querer que um assistente consulte materiais públicos de documentação antes de responder a perguntas técnicas. A busca pode ajudar a localizar páginas pertinentes; a extração pode fornecer trechos para análise; e um pipeline de recuperação pode organizar os documentos. Para que a experiência seja confiável, é necessário indicar quando a resposta se apoia em determinado material, lidar com versões antigas e evitar que páginas irrelevantes contaminem o contexto.
Monitoramento de informações públicas
Organizações podem acompanhar mudanças em páginas públicas que sejam relevantes para suas atividades, desde que a coleta seja permitida e realizada dentro de limites apropriados. O propósito pode ser perceber que um conteúdo foi atualizado, identificar a existência de uma nova página ou organizar materiais disponíveis. Um processo desse tipo exige regras claras sobre frequência, escopo e retenção dos dados, além de métodos para distinguir alterações significativas de mudanças meramente visuais.
Pesquisa e organização de conteúdo
Profissionais que pesquisam determinado tema podem usar ferramentas automatizadas para localizar páginas e criar uma coleção inicial de materiais. Isso pode poupar etapas repetitivas, mas não substitui a leitura crítica. Resultados de busca podem refletir a forma como a consulta foi formulada, e uma coleta extensa pode incluir material de baixa qualidade. Revisão humana e critérios editoriais continuam importantes quando os achados serão usados para produzir conteúdo ou orientar decisões.
Prototipagem de agentes
Em uma prova de conceito, uma equipe pode testar como um agente se comporta quando recebe acesso a operações de busca e coleta. O objetivo pode ser verificar se a arquitetura atende a uma tarefa delimitada, se os dados retornados são úteis e se o fluxo consegue lidar com erros. Antes de levar um protótipo para uso amplo, convém estabelecer limites de acesso, avaliar custos e latência e testar situações em que as páginas estão indisponíveis ou contêm informações conflitantes.
Cuidados técnicos antes de integrar uma API
Definir a tarefa com precisão
O primeiro passo é esclarecer que problema a integração deve resolver. “Dar acesso à internet para um agente” é uma descrição ampla demais para orientar uma implementação. A equipe pode especificar quais tipos de consulta serão permitidos, quais páginas podem ser acessadas, qual formato de resposta é necessário e como será avaliada a utilidade dos dados. Uma tarefa delimitada ajuda a evitar coleta excessiva e facilita a comparação entre opções.
Verificar documentação e limites
Antes de desenvolver, é recomendável examinar a documentação oficial e confirmar quais operações existem, como são chamadas e que respostas produzem. Também é necessário verificar limites de uso, requisitos de autenticação, tratamento de erros, condições comerciais e políticas relacionadas a dados. Como o anúncio resumido não apresenta esses detalhes, não é possível presumir que um recurso, parâmetro ou garantia específica esteja disponível.
Projetar segurança e controle de acesso
Uma chave de API deve ser protegida como uma credencial. Ela não deve ser exposta em interfaces públicas, repositórios abertos ou registros que possam ser acessados por pessoas não autorizadas. Sistemas em produção costumam precisar de gestão segura de segredos, rotação de credenciais, controle de permissões e acompanhamento das solicitações. A aplicação também deve decidir quais usuários ou processos podem acionar consultas e em que circunstâncias.
Tratar erros e respostas incompletas
Uma solicitação pode falhar, retornar poucos dados ou encontrar uma página que mudou desde a última consulta. O agente deve estar preparado para reconhecer essas situações e evitar preencher lacunas com informações inventadas. Em vez de tratar qualquer resposta como evidência suficiente, o pipeline pode verificar se o conteúdo recebido atende a critérios mínimos, registrar a falha e pedir uma nova tentativa ou encaminhar a tarefa para revisão.
Controlar volume, frequência e custo
Automatizar solicitações pode ampliar o volume de acessos rapidamente. Um projeto precisa estimar quantas consultas serão feitas, com que frequência e para quais finalidades. Controles de taxa e limites por usuário ou tarefa podem ajudar a manter o uso previsível. Também convém acompanhar o custo total da solução, incluindo não apenas a API, mas infraestrutura, armazenamento, processamento, avaliação e manutenção.
Qualidade, contexto e atualização dos dados
Dados encontrados na web não são automaticamente precisos, neutros ou atuais. Uma página pode ter sido publicada há bastante tempo, conter erros ou apresentar uma opinião como se fosse um fato. Além disso, conteúdos distintos podem divergir sobre o mesmo assunto. Um agente precisa de mecanismos para lidar com essas diferenças e, quando apropriado, comunicar que a informação é incompleta ou que há mais de uma interpretação.
A atualização também merece atenção. Uma resposta pode depender de uma página que foi modificada, removida ou reorganizada. Um pipeline pode guardar resultados em cache ou conservar documentos em uma base própria, mas cada decisão tem consequências: armazenar por mais tempo pode melhorar a velocidade, enquanto consultar novamente pode aumentar a atualidade e o volume de solicitações. A política adequada depende da natureza da tarefa e das regras aplicáveis.
Quando a informação é usada para orientar uma decisão importante, não basta medir se o agente conseguiu obter conteúdo. É necessário avaliar se encontrou fontes pertinentes, se preservou o significado dos trechos e se a resposta final corresponde ao material. Testes com consultas representativas, revisão de amostras e acompanhamento de erros podem revelar problemas que passariam despercebidos em uma demonstração curta.
Privacidade, direitos e uso responsável
O acesso automatizado a páginas deve considerar a diferença entre informação publicamente acessível e informação livre de restrições. Um dado disponível on-line pode estar sujeito a condições de uso, proteção de dados pessoais, direitos autorais ou outras regras. A equipe deve analisar quais informações são realmente necessárias, evitar coletar dados pessoais sem justificativa e estabelecer critérios para armazenamento e descarte.
Também é importante respeitar instruções e restrições apresentadas pelos sites consultados. A forma de acesso, a frequência das solicitações e a finalidade da coleta podem afetar a relação com os responsáveis pelos conteúdos. A existência de uma ferramenta técnica para automatizar operações não substitui uma análise jurídica ou de conformidade. Organizações devem buscar orientação adequada quando o risco ou a sensibilidade dos dados justificar esse cuidado.
Outro ponto é a segurança do conteúdo recebido. Páginas podem incluir instruções maliciosas, conteúdo enganoso ou elementos que tentem influenciar o comportamento de um agente. O sistema não deve tratar todo texto recuperado como uma ordem confiável. A aplicação precisa separar instruções do usuário, regras internas e material consultado, além de impedir que conteúdo externo altere permissões ou provoque ações não autorizadas.
Como avaliar se a solução se encaixa no projeto
Uma avaliação inicial pode começar com um caso de uso pequeno e mensurável. A equipe escolhe um conjunto limitado de consultas, define o que seria uma resposta útil e testa se as operações disponíveis conseguem fornecer dados adequados. Esse exercício deve incluir cenários comuns e casos problemáticos, como páginas inacessíveis, resultados duplicados, conteúdo desatualizado e respostas vazias.
Depois, é possível comparar a solução com a arquitetura existente. Se a empresa já utiliza serviços de busca, ferramentas de extração ou sistemas internos de indexação, a integração unificada pode simplificar alguma etapa ou criar sobreposição. A decisão não deve se basear apenas na quantidade de funções reunidas em uma API, mas na adequação ao fluxo, na facilidade de manutenção e nos requisitos de governança.
Uma avaliação completa também considera a experiência dos desenvolvedores. Boa documentação, exemplos claros, respostas previsíveis e mensagens de erro úteis podem fazer diferença na manutenção. Em aplicações que precisam escalar, a equipe pode analisar estabilidade, desempenho e mecanismos de observabilidade. Esses critérios precisam ser verificados diretamente, pois não estão detalhados no anúncio resumido da ferramenta.
O que a novidade indica para o desenvolvimento de IA
A apresentação de uma API que combina operações de busca e coleta reflete uma necessidade prática: agentes e sistemas de recuperação dependem de uma maneira organizada de consultar informações externas. Em vez de tratar o acesso à web como uma função isolada, equipes podem encará-lo como uma cadeia de atividades que começa na descoberta de páginas e pode terminar na preparação de contexto para um modelo ou uma aplicação.
Isso não significa que todo agente precise navegar pela web nem que centralizar operações seja sempre a melhor escolha. Algumas tarefas funcionam melhor com bases internas revisadas, catálogos controlados ou integrações diretas com sistemas de uma organização. Em outros casos, consultar páginas públicas pode ser pertinente. O desenho adequado depende do que o usuário precisa, do nível de confiança exigido e dos riscos de cada fonte.
O anúncio da Decodo coloca a Web Data API como uma opção voltada a agentes de IA e pipelines de recuperação. Para equipes interessadas, a próxima etapa é compreender os detalhes concretos da oferta e testá-la em tarefas reais, com critérios de qualidade e segurança definidos. A promessa de reunir operações sob uma chave pode simplificar parte da conexão, mas os resultados continuam dependendo de decisões de arquitetura, governança e avaliação.
Da experimentação à aplicação prática
Para sair de uma demonstração e chegar a uma aplicação confiável, é útil começar por perguntas simples: quais informações o agente precisa encontrar? Quais fontes são aceitáveis? Como o sistema indicará a origem do conteúdo? O que acontecerá quando os resultados forem insuficientes? Quem poderá revisar as respostas? Essas perguntas ajudam a transformar uma integração técnica em um processo compreensível e controlável.
Uma equipe também pode separar as responsabilidades. A camada de acesso consulta e obtém dados; a camada de processamento organiza e filtra; o modelo interpreta o contexto; e a aplicação decide como apresentar o resultado ou executar uma ação. Essa separação facilita identificar falhas e evita atribuir à API a responsabilidade por decisões que pertencem a outros componentes. Quanto mais importante for a tarefa, maior a necessidade de registros, testes e revisão.
O avanço de agentes conectados a fontes externas torna mais relevante a capacidade de avaliar não apenas se um sistema responde, mas de onde veio a informação e como foi tratada. Uma API pode oferecer uma peça útil dessa arquitetura, sem substituir o julgamento sobre fontes, finalidade e contexto. Para empresas que estão explorando inteligência artificial, experimentar com escopo limitado e controles claros é uma forma mais segura de aprender do que conceder acesso amplo sem critérios definidos.
A Sorting pode ajudar empresas a avaliar como integrar ferramentas de dados e inteligência artificial à sua estratégia digital, começando pelas necessidades reais do negócio e não pela adoção de tecnologia por impulso. O trabalho pode envolver a organização dos objetivos, a análise de jornadas e conteúdos, a definição de prioridades e a identificação de oportunidades para melhorar a presença digital. No caso de agentes conectados à web, também é importante pensar na qualidade das informações, na experiência das pessoas e nos critérios de mensuração. Assim, a discussão sobre APIs deixa de ser apenas técnica e passa a contribuir para decisões mais consistentes de comunicação e marketing.
Postar Comentário